作业题目
本次作业包含神经网络的一次前向与反向传播,以及 Sigmoid 导数和 log-softmax 梯度。
参考答案
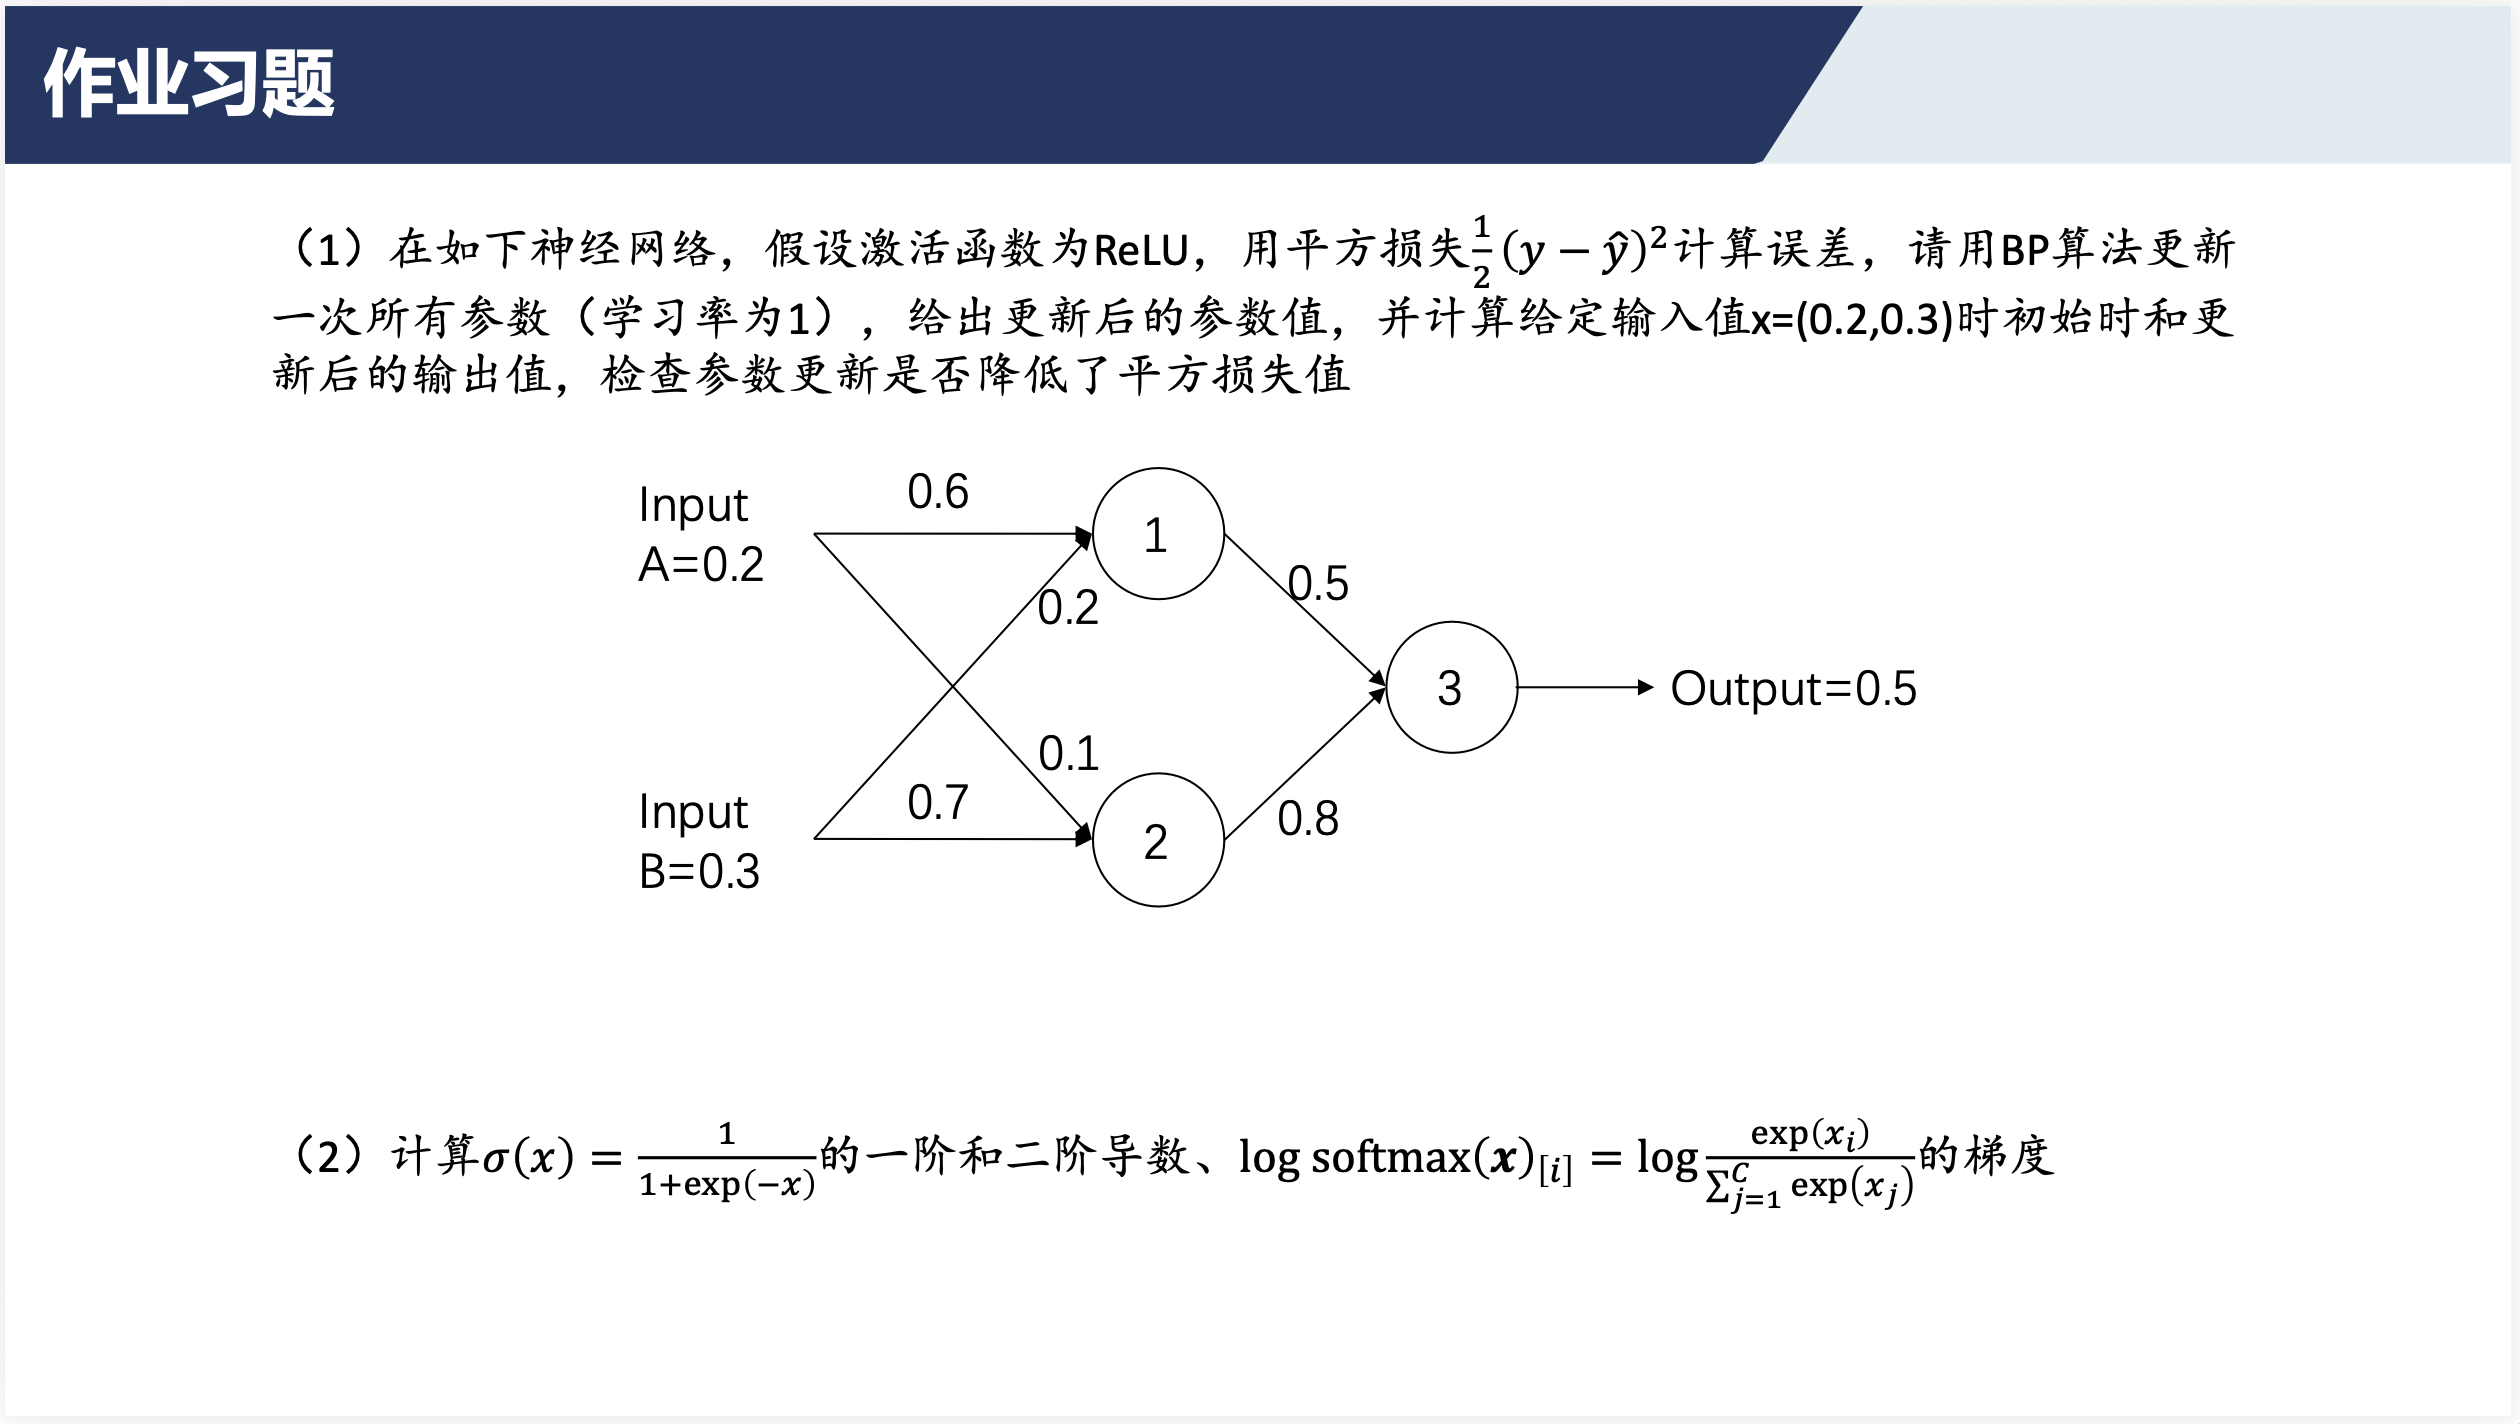
(1)一次前向传播与反向传播
约定与网络结构
输入为 \(A=0.2\)、\(B=0.3\),图中 Output=0.5 解释为监督学习的目标值 \(y=0.5\),而非网络已经计算出的预测值。图中没有给出偏置,因此按无偏置网络计算,待更新参数为六个连接权重。节点 1、2 是隐藏节点,节点 3 是输出节点;各节点均使用 \(\operatorname{ReLU}(z)=\max(0,z)\)。
记输入到隐藏层的权重为 \(w_{A1},w_{B1},w_{A2},w_{B2}\),隐藏层到输出层的权重为 \(v_1,v_2\),则
\[\begin{aligned} z_1&=w_{A1}A+w_{B1}B,&h_1&=\operatorname{ReLU}(z_1),\\ z_2&=w_{A2}A+w_{B2}B,&h_2&=\operatorname{ReLU}(z_2),\\ z_3&=v_1h_1+v_2h_2,&\hat y&=\operatorname{ReLU}(z_3),\\ L&=\tfrac12(y-\hat y)^2. \end{aligned}\]初始权重依次为 \((0.6,0.2,0.1,0.7,0.5,0.8)\)。学习率 \(\eta=1\),更新规则为 \(\theta^{\mathrm{new}}=\theta-\eta\,\partial L/\partial\theta\)。
第一步:前向传播
\[\begin{aligned} z_1&=0.6\times0.2+0.2\times0.3=0.18,&h_1&=0.18,\\ z_2&=0.1\times0.2+0.7\times0.3=0.23,&h_2&=0.23,\\ z_3&=0.5\times0.18+0.8\times0.23=0.274,&\hat y&=0.274. \end{aligned}\]三个 \(z\) 均为正,因此本次计算的三个 ReLU 都原样传递数值,其局部导数都为 1。初始损失为
\[\boxed{L_{\mathrm{old}}=\tfrac12(0.5-0.274)^2=0.025538}.\]第二步:把误差沿计算图反向传递
先计算输出对损失的影响,再逐层乘上局部导数。记 \(\delta_k=\partial L/\partial z_k\)。
\[\frac{\partial L}{\partial\hat y}=\hat y-y=-0.226, \qquad \delta_3=(\hat y-y)\operatorname{ReLU}'(z_3)=-0.226.\]输出层权重的梯度为
\[\begin{aligned} \frac{\partial L}{\partial v_1}&=\delta_3h_1=-0.226\times0.18=-0.04068,\\ \frac{\partial L}{\partial v_2}&=\delta_3h_2=-0.226\times0.23=-0.05198. \end{aligned}\]隐藏节点的误差信号为
\[\begin{aligned} \delta_1&=\delta_3v_1\operatorname{ReLU}'(z_1)=-0.226\times0.5=-0.113,\\ \delta_2&=\delta_3v_2\operatorname{ReLU}'(z_2)=-0.226\times0.8=-0.1808. \end{aligned}\]输入到隐藏层的权重梯度为
\[\begin{aligned} \frac{\partial L}{\partial w_{A1}}&=\delta_1A=-0.113\times0.2=-0.02260,\\ \frac{\partial L}{\partial w_{B1}}&=\delta_1B=-0.113\times0.3=-0.03390,\\ \frac{\partial L}{\partial w_{A2}}&=\delta_2A=-0.1808\times0.2=-0.03616,\\ \frac{\partial L}{\partial w_{B2}}&=\delta_2B=-0.1808\times0.3=-0.05424. \end{aligned}\]全部梯度都在同一组旧参数处计算。 例如,计算 \(\delta_1,\delta_2\) 时应使用旧的 \(v_1=0.5,v_2=0.8\),不能先改输出层权重,再用新权重计算隐藏层梯度。
第三步:同时更新所有权重
| 参数 | 原值 | 梯度 \(\partial L/\partial\theta\) | 新值 \(\theta-\partial L/\partial\theta\) |
|---|---|---|---|
| \(w_{A1}\) | 0.6 | −0.02260 | 0.62260 |
| \(w_{B1}\) | 0.2 | −0.03390 | 0.23390 |
| \(w_{A2}\) | 0.1 | −0.03616 | 0.13616 |
| \(w_{B2}\) | 0.7 | −0.05424 | 0.75424 |
| \(v_1\) | 0.5 | −0.04068 | 0.54068 |
| \(v_2\) | 0.8 | −0.05198 | 0.85198 |
这里梯度全为负,梯度下降使六个权重都增大。这与直觉一致:初始预测偏小,而本题输入和激活值均为正,适当增大权重可以提高输出。
第四步:用新参数重新前向传播并比较损失
\[\begin{aligned} z_1^{\mathrm{new}}&=0.62260\times0.2+0.23390\times0.3=0.194690,\\ z_2^{\mathrm{new}}&=0.13616\times0.2+0.75424\times0.3=0.253504,\\ z_3^{\mathrm{new}}&=0.54068\times0.194690+0.85198\times0.253504\\ &=0.32124532712. \end{aligned}\]新的三个 \(z\) 仍均为正,所以
\[\boxed{\hat y_{\mathrm{new}}=0.32124532712}, \qquad \boxed{L_{\mathrm{new}}=\tfrac12(0.5-0.32124532712)^2 =0.0159766165382179037472}.\]因此 \(L_{\mathrm{new}}<L_{\mathrm{old}}\),损失下降约 37.44%。本题学习率为 1 的这一步确实降低了损失;一般情形下,学习率过大仍可能使损失上升,不能只根据“沿负梯度方向”就断言任意步长都会改善。
(2)Sigmoid 的导数与 log-softmax 的梯度
Sigmoid 的一阶导数
对标量 \(x\),记
\[\sigma(x)=\frac{1}{1+e^{-x}}.\]由链式法则,
\[\sigma'(x)=-(1+e^{-x})^{-2}(-e^{-x}) =\frac{e^{-x}}{(1+e^{-x})^2} =\boxed{\sigma(x)\bigl(1-\sigma(x)\bigr)}.\]Sigmoid 的二阶导数
对上一式使用乘积法则,
\[\begin{aligned} \sigma''(x) &=\sigma'(x)(1-\sigma(x))-\sigma(x)\sigma'(x)\\ &=\sigma'(x)(1-2\sigma(x))\\ &=\boxed{\sigma(x)(1-\sigma(x))(1-2\sigma(x))}\\ &=\frac{e^{-x}(e^{-x}-1)}{(1+e^{-x})^3}. \end{aligned}\]核对:\(\sigma(0)=1/2\),故 \(\sigma'(0)=1/4\)、\(\sigma''(0)=0\);\(x<0\) 时二阶导数为正,\(x>0\) 时为负,与 Sigmoid 在原点两侧的弯曲方向一致。
log-softmax 的梯度
这里 \(x=(x_1,\ldots,x_C)^\top\in\mathbb R^C\)。定义
\[p_j=\frac{e^{x_j}}{\sum_{k=1}^Ce^{x_k}}, \qquad \ell_i(x)=\log\operatorname{softmax}(x)_{[i]} =x_i-\log\left(\sum_{j=1}^Ce^{x_j}\right).\]固定分量 \(i\),对任意 \(x_k\) 求偏导:
\[\frac{\partial\ell_i}{\partial x_k} =\mathbf 1_{\{i=k\}}-\frac{e^{x_k}}{\sum_{j=1}^Ce^{x_j}} =\boxed{\mathbf 1_{\{i=k\}}-p_k}.\]因此,题目中第 \(i\) 个 log-softmax 分量的梯度为
\[\boxed{\nabla_x\ell_i=e_i-p\in\mathbb R^C},\]其中 \(e_i\) 是第 \(i\) 个标准基向量,\(p=(p_1,\ldots,p_C)^\top\)。具体而言,对自身分量求导得到 \(1-p_i\),对其他分量求导得到 \(-p_k\)。
若将整个 log-softmax 向量对 \(x\) 求导,则得到 \(C\times C\) 的雅可比矩阵。以行表示输出分量、列表示输入分量,有
\[\boxed{J_{ik}=\mathbf 1_{\{i=k\}}-p_k,\qquad J=I-\mathbf 1p^\top}.\]核对:每行元素之和为 \(1-\sum_kp_k=0\)。这对应于对所有输入同时加上同一常数时,softmax 与 log-softmax 都不变。
交互演示与复核
打开 一条误差的旅程,按步骤查看加权求和、ReLU、损失、反向梯度和同时更新后的结果。页面可以调整输入、目标、权重和学习率,也可点击连接查看该权重的链式法则。
数值核验使用独立的中心差分:将一个参数分别增加、减少 \(\varepsilon\),比较
\[\frac{L(\theta+\varepsilon e_k)-L(\theta-\varepsilon e_k)}{2\varepsilon} \quad\text{与}\quad\frac{\partial L}{\partial\theta_k}.\]复核脚本 verify.cjs 检查六个权重梯度、更新前后的输出与损失,以及 Sigmoid 导数和 log-softmax 雅可比。运行方法:在本目录下执行 node verify.cjs。数值差分使用 \(\varepsilon=10^{-6}\);本题所有激活输入远离 ReLU 的不可导点 0。